「ChatGPTがRAGで参照するWebページは、GoogleやBingの検索結果から来ている」という前提は古くなりつつあるかも知れません。生ログからOpenAIのbotの挙動を観測すると、OpenAIは既にGoogleに匹敵するクロール網を整えつつあるようです。
本記事では、自社サイト( ayudante.jp )の生ログでOpenAIのクローラーを約半年間観測して見えてきた新事実と、そこから見えてきた「ChatGPT対策でサイト運営者が今できること」をご紹介いたします。
※ 本記事は JADEcon 2026(JADE 秋のSEO収穫祭) のLT「ChatGPTはどのように新着ページを発見するのか」でお話しした内容を、記事として簡略化して再編集したものです。
数値・挙動は執筆時点(2026年10月、観測期間は2026年3月〜9月を中心とした約半年)の ayudante.jp のサイトの観測結果です。他サイトではOpenAIのbotが異なる動きをしている可能性があります。また、OpenAIのbotの挙動は観測期間中にも何度も変化しており、今後も変わる可能性が高い点にご注意ください。
- 分析基盤の紹介
- 独自インデックス「Labrador」の影
- Googlebot並みの「網羅性」
- クロール効率を支える「URL管理台帳」
- 見つけたら即クロール「新着ページの発見能力」
- Googlebotにはまだ及ばない「成熟度」
- サイト運営者が今できること
- おわりに
分析基盤の紹介
はじめに、OpenAIはChatGPTのために3つのbotを運用しています。( Overview of OpenAI Crawlers – https://developers.openai.com/api/docs/bots )
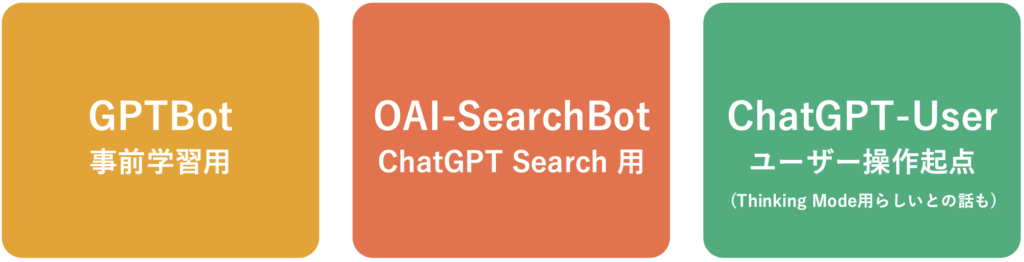
ChatGPT Search、いわゆるWeb検索型のRAG(検索拡張生成)用に運用されているbotがOAI-SearchBotです。
本調査では、これら3つのbotの挙動を生ログから分析して、OpenAIのbotとその裏側にある仕組みを調査しました。
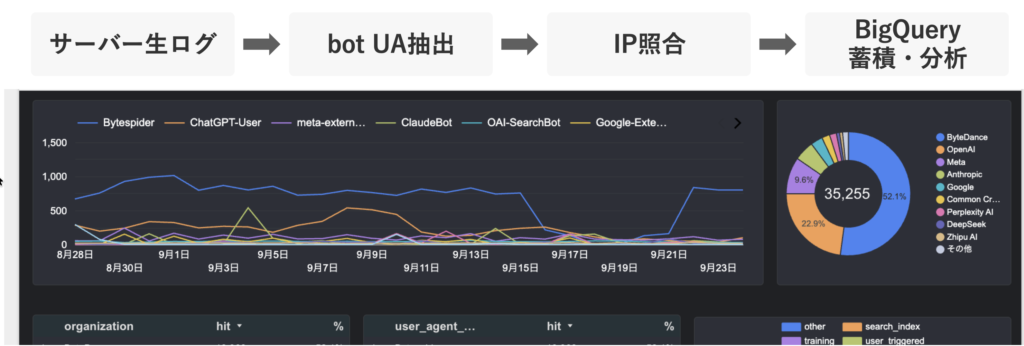
また、本分析は、OpenAIの公式ドキュメントのIPレンジと照合の上、本物であることが保証されたログのみを対象としています。OpenAIのbotを名乗るアクセスの約半数はニセモノのため、この工程はとても重要です。
独自インデックス「Labrador」の影
2026年8月17日、「ChatGPTはGoogle/Bing頼み」という認識を揺るがすフランスRESONEO社のOlivier de Segonzac氏による調査「Inside ChatGPT’s retrieval stack: The index, cache, and pages it actually reads」がSearch Engine Landに公開されました。
要約すると、ChatGPTの通信に含まれていた result_source というフィールドから検索結果の供給源を特定したところ、Google由来のscraped results(bright、Oxylabs経由)と並んで、Labradorと呼ばれるOpenAI独自のインデックスが存在し、無償ユーザーの既定モード(Instant)ではこのLabradorが主要な供給源になっている、という内容です。残念なことに、このフィールドは7月21日に削除されたため、現在は直接の追試はできません。
同様の報告は他にもあります。Peec AI社の調査「ChatGPT built its own search index」では、LabradorがWeb・ニュース・ショッピングなど用途別に分かれたインデックス群であること、Googleの反トラスト裁判の証言からOpenAIが2023年には独自インデックスの構築に着手していたこと、ショッピング領域では自前インデックスを外部の検索結果より優先するA/Bテストが進行中であることまで報告されています。
LLM対策の情報には真偽不明の情報が溢れており、裏取りを行うことは重要です。そこで今回、「自社サーバーのログに写るbotの挙動から、OpenAIの独自インデックスの実在と性質を推測できないか」調査を行ったところ、想像以上に面白い発見がありました。
Googlebot並みの「網羅性」
ayudante.jp の正規URL約1,400本について、半年間にクロールされたページの割合を比較しました。
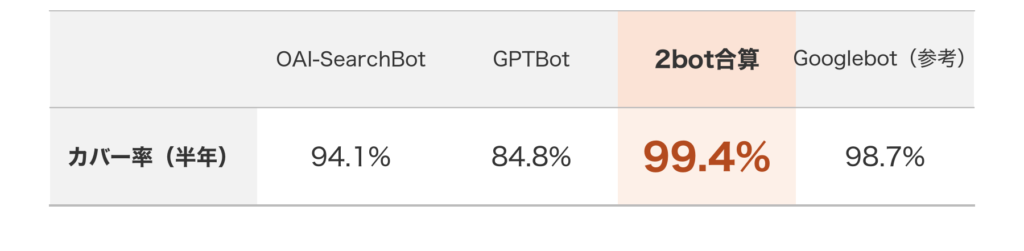
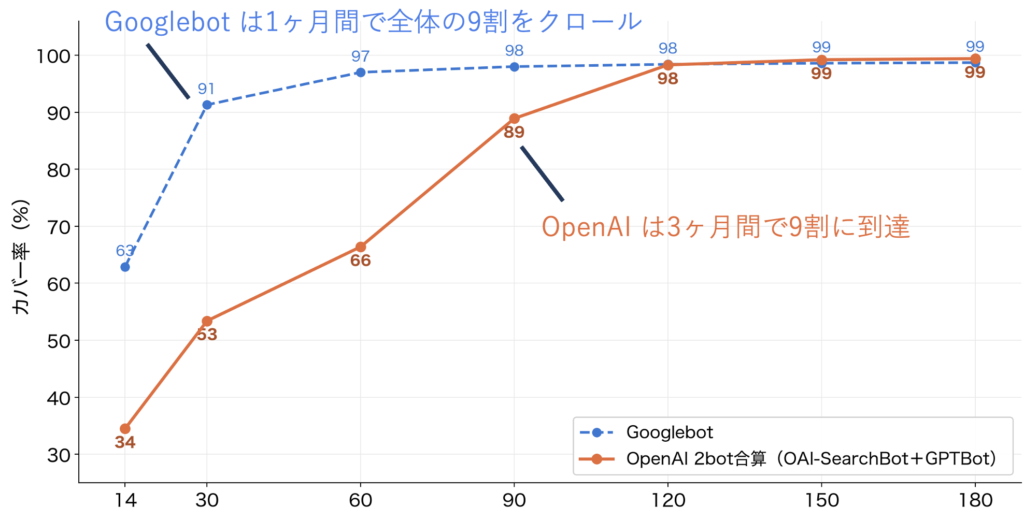
OAI-SearchBotとGPTBotを合わせると、サイトのほぼ全ページ(99.4%)に到達しており、面のカバーという意味では既にGooglebotと同水準でした。
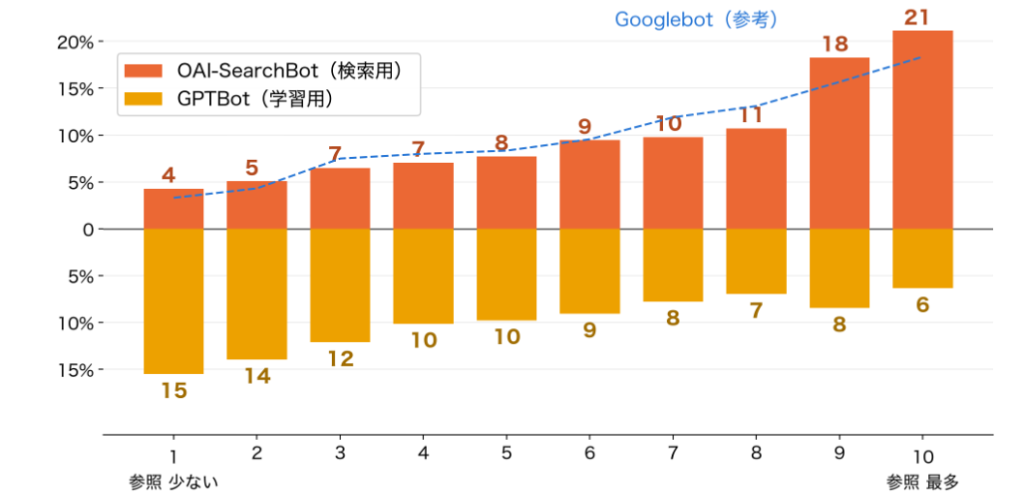
OAI-SearchBotとGPTBotは互いの重複を避けるように、OAI-SearchBotはChatGPT-Userからの参照が多いページと新着ページを中心に巡回し、GPTBotは幅広いページを巡回しています。
OpenAIは「両botを許可したサイトでは1回のクロールを両用途に使うことがある」と説明しており、2つのクローラーが1つの収集網として機能している様子がアクセスログにも現れていました。
各記事ページへのOAI-SearchBot・GPTBotの訪問数をChatGPT-User の参照数(ユーザー需要)で ソートした結果
クロール効率を支える「URL管理台帳」
OAI-SearchBotのログには、「URL管理台帳を運用している」と考えないと説明のつかない挙動が2つ写っていました。
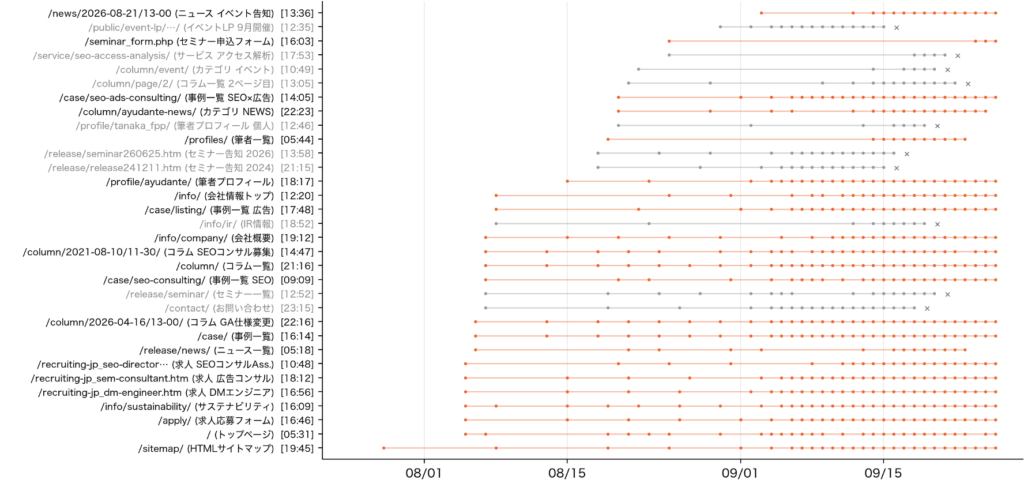
1つ目は秒精度の定時巡回です。約20のページを、毎日決まった時刻に巡回しています。たとえばコラム一覧ページ( /column/ )へは毎晩21時16分29秒±3秒に訪問があります。この挙動は8月上旬に始まり、9月上旬からは毎日の巡回になりました。同じ基準でログに現れる29種類のbot(Googlebot, Bingbotなど)をすべて調べましたが、秒精度の定時巡回を行っているのはOAI-SearchBotだけです。
定時巡回の対象ページは固定ではなく、入れ替え・拡大しながら再編成され続けています。
ayudante.jp の定時巡回されているページ
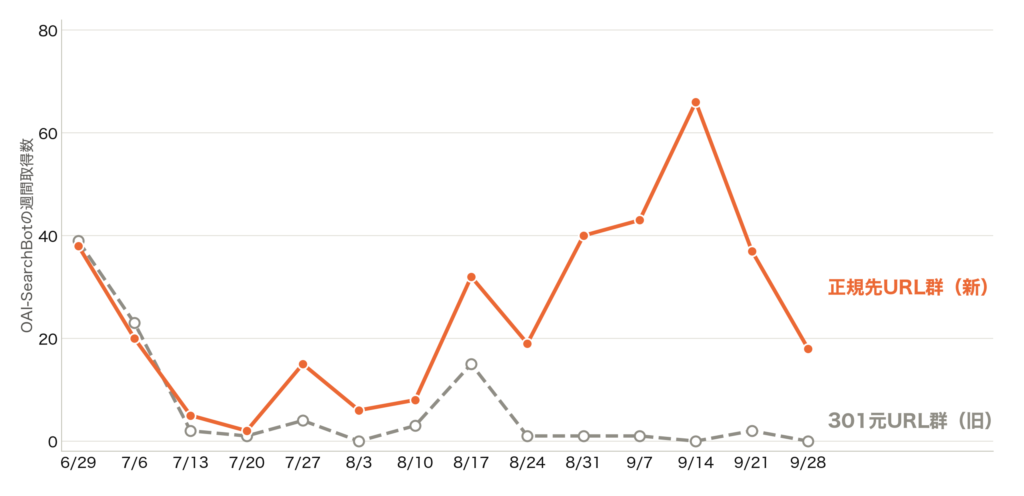
2つ目は、301/404の記憶です。リダイレクトやリンク切れのURLを数ヶ月かけて確認し、サイト内にリンクが残っていても訪問を打ち切ります。尚、この挙動はGPTBot側には見られず、台帳の共有は部分的なようです。
これらはOpenAI内部でURL管理台帳を運用していると考えなければ説明がつかない挙動です。限られたクロール資源を無駄なく使うための仕組みと考えると、どの挙動も腑に落ちます。
見つけたら即クロール「新着ページの発見能力」
新着記事が公開されてからOAI-SearchBotがクロールするまでの時間は、Googlebotとほぼ変わらず、ほとんどの記事が公開当日中にクロールされていました。具体的には、新着記事の77%でGooglebotの到達と±10分以内、51%ではGooglebotより先に到達していました。Googleの検索結果に収録されるよりも明らかに早いタイミングで到達しています。
OAI-SearchBotの新着記事への初回到達の「直前」に取得していたページを調べたり、リンクを一時削除したりすることで、OAI-SearchBotの新着記事の発見経路も特定しました。 ayudante.jp では OAI-SearchBotがChatGPTユーザーから需要が高いコラムページをランダム巡回する中で、コラム内の”最近の記事”のリンクから新着コラムのURLを発見していました。
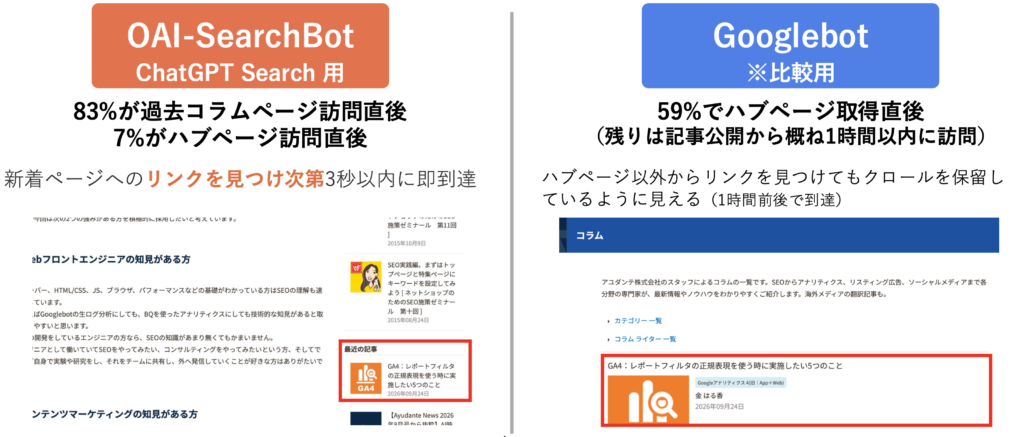
このように、OAI-SearchBotはページの定時巡回・ランダム巡回中に新しいURLへのリンクを発見すると、即クロールしに行くという、他のbotには見られない特徴的な動きを行なっています。
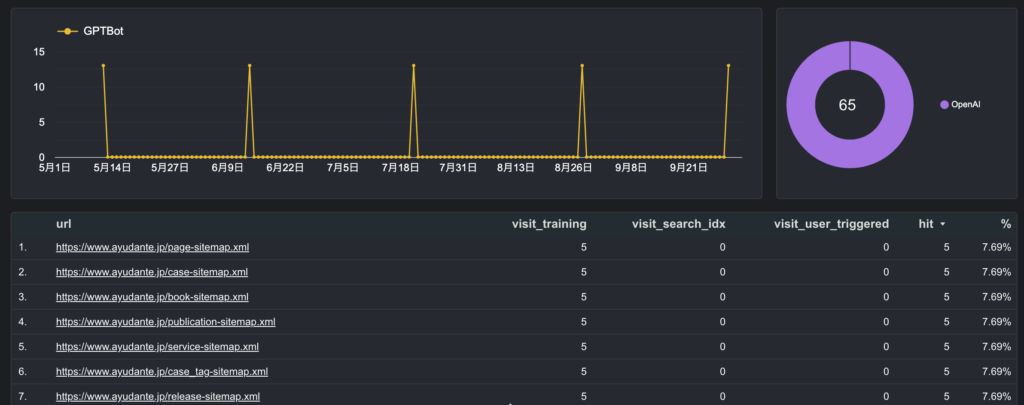
一方で、当サイトにおいてはXMLサイトマップは新着ページの発見経路としては全く機能していません。定期的にクロールされているものの、頻度が月1回ペースと低すぎる上、参照しているのはGPTBot側で、OAI-SearchBotではないので、インデックス用途で使われているのかも不明です。
Googlebotにはまだ及ばない「成熟度」
ここまでのお話で、OAI-SearchBotが既にGooglebotに匹敵するクロール能力をある程度備えているということが分かりました。しかし、その成熟度では遠く及ばない点が目立ちます。
サイト内ページを網羅するまでに掛かる時間
サイトの9割をクロールするまでの期間で評価すると、Googlebotが約1ヶ月に対し、OpenAIの2botは約3ヶ月と、約3倍の差があります。サイト全体を巡回する速さ・更新し続ける能力はまだまだです。
定時巡回するページの選定がイマイチ
毎日の定時巡回の対象に、すでに終了したイベント告知ページが含まれるなど、選定のセンスはイマイチです。更新頻度やリンク数など複数の軸で調べましたが、選定基準はどれとも相関が見つかりませんでした。
OpenAIが定時巡回しているページの例
- TOPページ – https://ayudante.jp/
- 謎のパラメータ付きTOPページ – https://ayudante.jp/?utm-campaign=themeisle-wordpress
- HTMLサイトマップ – https://ayudante.jp/sitemap/
- コラム一覧ページ – https://ayudante.jp/column/
- サステナビリティページ – https://ayudante.jp/info/sustainability/
- 終了したイベントの告知ページ(非正規URL) – https://ayudante.jp/news/2026-08-21/13-00
- 10年前の採用コラムページ – https://ayudante.jp/column/2016-02-10/12-22/
鮮度管理の仕組みがない
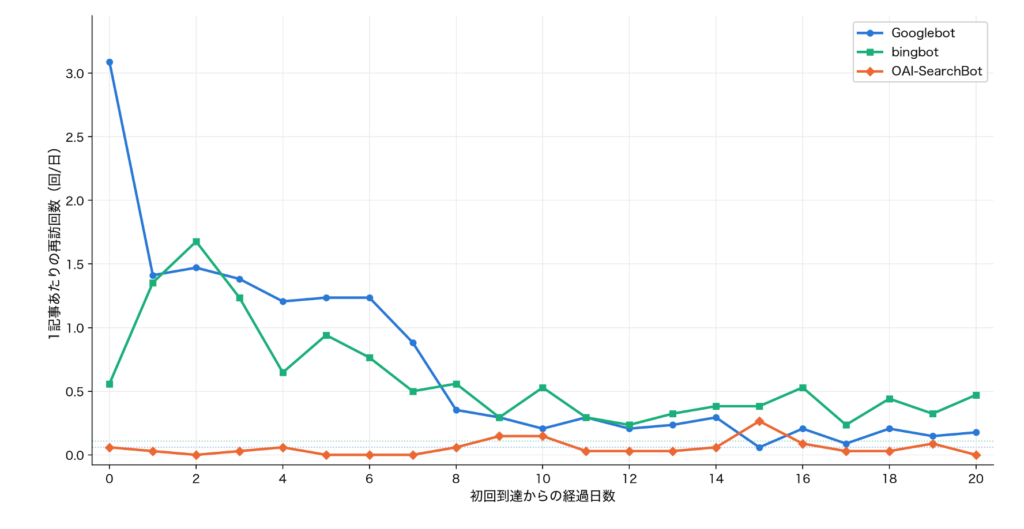
GoogleやBingには新着ページをしばらく高頻度で再訪する仕組みがありますが、OAI-SearchBotの挙動からはこれが確認できませんでした。公開後7日以内に再訪があった新着ページは18%にとどまり、再訪間隔の中央値は15日と、通常ページのクロールとの違いが認められません。このため、一度公開したページの内容を後から変更しても中々気づいてもらえない懸念があります。
新着記事へ初回到達後、同一記事を再クロールする頻度の推移
このほか、URLの正規化やレンダリング能力も、Google検索の水準には到底及びません。普段はGoogleが賢いので意識せずに済んでいたことですが、OpenAIのクローラーが相手になると、HTMLやURLの設計から文章の書き方まで、基礎的な部分で「機械に優しい」作りを改めて意識した方が良いのかな、というのが観測を終えての感想です。
サイト運営者が今できること
ここまで見てきたとおり、ChatGPT(無償版)はOpenAIの独自インデックスを利用している可能性が高く、これを踏まえて、もし今ChatGPT対策に取り組むのであれば、次の3つの対応が考えられます。
内部リンクの動線を整える
新着ページへのリンクを高需要ページや記事テンプレートに常設しましょう。OpenAIのbotに対しては、これが発見の最速経路となります。ハブページからリンクを行なっていても、そのハブページが定期巡回対象になっていない場合、新着ページが中々発見されない可能性があります。
公開時点のページ品質を上げる
新着ページに高頻度で再訪する動きが確認できない以上、「不完全な状態でページを公開して、あとから直す」運用は、無償ChatGPTユーザー向けには不利に働く可能性があります。十分にページ内容をレビューした上で公開を行いましょう。
また、RESONEO社の調査によると、OpenAIの独自インデックスがページ本文の代わりに保持するのは「ページタイトルとh1周辺の約200文字」のみで、meta descriptionは使われないと報告されています。同調査では、h1の直後には目次やパンくずリストなどの共通パーツではなく、記事の要点を置く構成が推奨されています。
OpenAIのbotのクロール状況を自社ログで測る
ChatGPTにはSearch Consoleがなく、仕様上botの挙動はGoogle Analyticsにも記録されないため、OpenAIによるクロール状況は生ログでしか確認できません。生ログを見れば、OAI-SearchBotやGPTBotが各ページに到達しているか(独自インデックスに収録されるための前提)、ChatGPT-User(ユーザーの操作をきっかけにページを取得するbot)に読み込まれているか(回答生成でのページ取得の実績)を、それぞれ確認できます。たとえばChatGPT-Userの読み込みが集中しているページが分かれば、優先的にリライトすべきページを判断する材料になるでしょう。
なお、冒頭で触れたとおりOpenAIのbotを名乗るニセモノが多いため、集計時はUser-Agent文字列だけでなく、公式IPレンジとの照合を忘れずに行いましょう。
おわりに
本記事では、OpenAIが独自のインデックスを運用している可能性を、botの挙動から推定しました。GoogleやBingに比べて限られた資源で膨大な検索を捌く必要があるOpenAIにとって、RAGのWebページ情報の供給元を自前のインデックスへ寄せていくのは自然な流れに思えます。
では、ChatGPT向けに特別な対策が必要なのでしょうか。答えはYESですが、特別な話ではありません。Google対策を基本としつつ必要に応じてBing対策を加えるのと同じように、ChatGPT対策も基本はGoogleを意識した設計のまま、JavaScriptレンダリングができないなど、Googleほど洗練されていないクローラーのために、一段「機械に優しい」配慮を加えるだけの話です。
一方で、LLM対策の情報には信頼性の低いものが溢れており、変化も速いため、過去に正しかったことが数ヶ月後には古くなっています。適切な情報であっても、サイトの種類や規模によってはそのまま当てはまらないこともあります。このコラムに書かれていることも例外ではありません。
自社サイトにとって何が正しい打ち手なのかを知る一番の近道は、自らの環境で検証することです。皆さんの環境でも、生ログ分析を始めてみませんか。